Présentiel 
À Paris 75 - le lieu sera communiqué par email

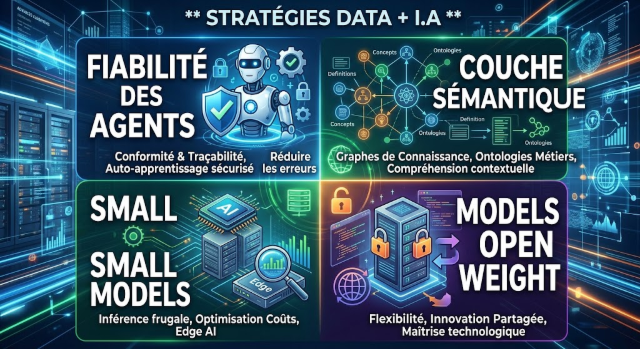
CoPil Data & IA : Fiabilité des Agents, Couche Sémantique, Small Models & Models Open Weight

Comité de Pilotage
Data & SI
IA & IAG
CoPil Data & IA : Fiabilité des Agents, Couche Sémantique, Small Models & Models Open Weight
Pour vous inscrire, connectez-vous en cliquant sur ce bouton :
Merci pour votre inscription !
Votre demande d’inscription a bien été enregistrée. Vous recevrez prochainement un email de confirmation de notre équipe.
Le Comité de Pilotage réunit tous les trimestres le membres décisionnaires de la communauté en format atelier ; les sujets traités émanent du groupe et sont traités entre pairs. Sur les sujets techniques, nous convions des confrères précurseurs à venir présenter un retour d'expérience ou à des conseils de cadrer et nourrir les échanges. Pour rejoindre le CoPil, n'hésitez pas à écrire à yulia.kurochkina@ebg.net /////////////////////////// 8H30 | Accueil des participants Café de bienvenue, networking et échanges informels entre CDOs. 8H45 - 9H15 | Intervention d'ouverture Sécurité, conformité, traçabilité : Rendre les Agents fiables et auto-apprenants Intervenants : • Olivier Favre, Head of Product and Master Data, Nestlé Purina Objectif de la session : Un retour d’expérience et une analyse pointue sur la gouvernance des agents IA. L'intervention se concentrera sur les défis de passage à l'échelle : comment intégrer l'auto-apprentissage tout en garantissant un cadre strict de conformité, de sécurité des données et de traçabilité des décisions algorithmiques au sein de grands groupes. 9H15 - 10H00 | Session interactive (Échanges entre pairs) Small LLM, Open Weight et Open Source : Maîtriser l'explosion de vos coûts d'inférence Objectif de la session : Alors que l'intégration de l'IA générative s'accélère, la gestion du ROI et des coûts d'inférence (FinOps appliqué à l'IA) devient critique. Cet échange permettra aux CDOs de comparer leurs stratégies de déploiement : arbitrage entre modèles propriétaires géants et modèles open-weight ou Small Language Models (SLM) plus frugaux, spécialisés et hébergés en local. 10H00 - 10H45 | Session interactive (Échanges entre pairs) Ontologies, Graphes et Modèles Sémantiques : réduire au maximum les erreurs des Agents La performance d’un agent ne dépend pas uniquement du modèle utilisé : elle repose également sur sa capacité à comprendre correctement les données, les concepts métier et les relations qui structurent l’entreprise. Ontologies, Knowledge Graphs, couches sémantiques et modèles de données peuvent constituer une infrastructure essentielle pour contextualiser les requêtes, limiter les hallucinations et rendre les réponses des agents plus précises et explicables. Questions proposées au débat : • Faut-il construire une couche sémantique pour industrialiser les usages agentiques ? • Quel rôle pour les Knowledge Graphs dans les architectures RAG et agentiques ? • Comment articuler données structurées, documents et connaissances métier ? • Qui doit porter la gouvernance des ontologies et des modèles sémantiques dans l’entreprise ? • Peut-on mesurer concrètement leur impact sur le taux d’erreur et la fiabilité des agents ?
Pour rappel, les inscriptions sont possibles :
- Pour les événements exécutifs (Task Forces, Business Talks, Dîners) et conférences : jusqu'à la veille de la session
- Pour les Webinars : jusqu'à 30mn avant la session en ligne

Passés ces délais, nous ne pourrons pas garantir votre inscription.
Dans tous les cas, nous vous invitons à prendre connaissance de la Charte des Adhérents de l'EBG. 

Vous souhaitez accéder à nos événements, formations et contenus ? Devenez membre de l’ebg !

D’autres événements susceptibles de vous intéresser